
HUD de hardware
GPU y VRAM por tarjeta, potencia, CPU, RAM, temperaturas, discos y estado de servicios.
Producto
Xeretron reúne modelos, hardware, voz, documentos, APIs, seguridad y operación en un sistema que vive dentro de tu organización. Esta página explica el problema que resuelve, qué verás en el panel y qué se necesita para ponerlo a operar.
El problema operacional
Cada conversación sale de la organización. Cada factura cambia con el uso. Cada cambio de proveedor o de precios obliga a rediseñar lo que ya estaba construido. Y la información más sensible de la institución termina gobernada por políticas ajenas.
Lo que se procesa en una nube externa deja de estar bajo tu gobierno diario.
El presupuesto depende de cuánto se use, y el uso rara vez se puede predecir.
Modelos, límites y precios cambian sin que la organización pueda decidir.
Chat, transcripción, OCR y APIs en servicios distintos, sin control unificado.
Vista unificada
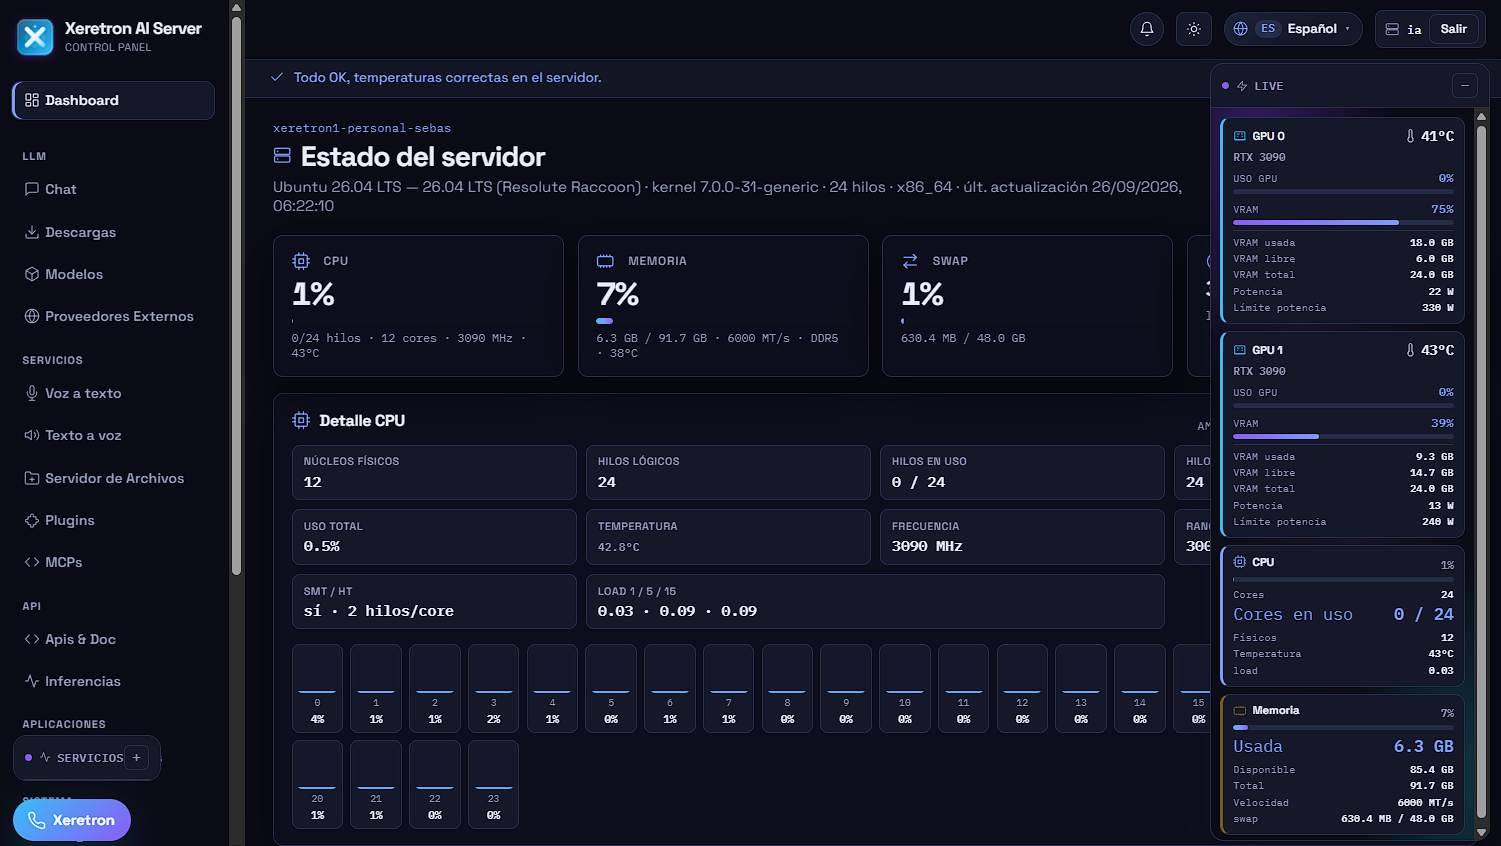
El panel de Xeretron muestra el estado del hardware, los modelos cargados, los servicios activos y la actividad de inferencia. La idea es simple: si puedes verlo, puedes operarlo.
GPU y VRAM por tarjeta, potencia, CPU, RAM, temperaturas, discos y estado de servicios.
Modelos disponibles, salud, carga y descarga, perfiles publicados y colas de descarga.
Streaming, adjuntos visuales, transcripción de audio y métricas por respuesta.
Endpoints publicados, claves con alcance y documentación para tus desarrolladores.
Historial de inferencias y registros de seguridad para revisar qué ocurrió y cuándo.
Puertos, servicios del sistema y consumo eléctrico administrados desde el panel.
Tour del panel
Cada operación deja información útil: qué modelo respondió, en qué lane corrió, cuánto tardó el primer token y a qué velocidad generó. Esa visibilidad es la que convierte una demo en una operación sostenida.
Capacidades en detalle
Cada motor resuelve una tarea concreta y comparte con el resto el mismo panel, la misma seguridad y la misma infraestructura.
Servidor de inferencia con modelos GGUF y streaming compatible con el formato OpenAI: contexto, hilos, atención rápida, caché KV y división por tarjetas. Límite honesto: no todo GGUF corre en cualquier binario o hardware; la compatibilidad se valida en la evaluación.
Modelos con componente visual y proyección multimodal, aceptando imágenes por URL o datos embebidos, para lectura de documentos, capturas y fotografías.
Carriles de ejecución base, gpu0, gpu1, dual y cpu. La concurrencia real está limitada por la memoria de video disponible: se dimensiona, no se promete a ciegas.
Flujo de borrador, prueba y publicación. Combinaciones de modelos guardadas y restaurables, con estimación previa de memoria para cada stack.
Suspende el stack habitual, carga un modelo de mayor tamaño y restaura la configuración tras la inactividad sin cortar inferencias activas. Puede tardar varios minutos.
Transcripción con Whisper en el propio nodo y descarga por inactividad para devolver GPU a las tareas principales.
PDF, Office, imágenes y hojas de cálculo convertidas a texto en español e inglés, listas para consultar o resumir con los modelos cargados.
Generación de audio bajo demanda dentro del nodo, para avisos, accesibilidad y productos que necesitan hablar.
Mediciones de latencia inicial y tokens por segundo en hardware real, contextualizadas; colas de descarga y almacenamiento de pesos administrados.
Endpoints sobre HTTPS con claves de acceso limitadas por alcance, para conectar aplicaciones internas o servicios existentes.
Integración con entornos de desarrollo de juegos y Unreal, telefonía SIP y sincronización entre nodos.
Con los modelos instalados, la operación local es posible. Las actualizaciones y descargas requieren conectividad, y así lo especificamos en cada despliegue.
Arquitectura
Diagrama público simplificado. No publicamos rutas internas, credenciales ni detalles sensibles del despliegue.
Requisitos y despliegue
Los requisitos dependen de los modelos y de la concurrencia esperada, por eso la evaluación previa es obligatoria. Como orientación general:
Cuéntanos qué datos, modelos y usuarios tienes en mente. Respondemos con una evaluación honesta, incluidos los casos en los que Xeretron no es la mejor opción.